
這幾天的 AI 圈,大概都被一個叫 Jev 的模型洗版了。
前 OpenAI 研究員、ChatGPT 共同發明者之一的 Diogo Almeida,帶著他的新公司 TypeSafe AI 和 4000 萬美元的種子輪資金,推出了一個「System One 模型」。官方宣稱:比前沿 LLM 快 193.6 倍、便宜 444.6 倍、而且零幻覺。
快 200 倍!?零幻覺!?(驚!!!)
看到這些數字,大部分人的反應是:「天啊好厲害」,然後開始轉發。但我的第一反應卻是——
「等等,它的輸出到底是什麼?」
因為,如果一個模型的輸出很簡單,那「快 200 倍」這件事的意義可能跟大家想的不太一樣。
與其跟著數字跑,不如我們自己來推推看。
Jev 到底在做什麼?
在拆解之前,得先看看 Jev 的 API 長什麼樣。簡單來說,它收三樣東西:
- State(情境描述):用自然語言描述當前狀況
- Question(問題):你想問什麼
- Options(選項):預先定義好的候選答案
然後它回傳的不是文字,而是每個選項的機率分數。就這樣。
舉個例子:
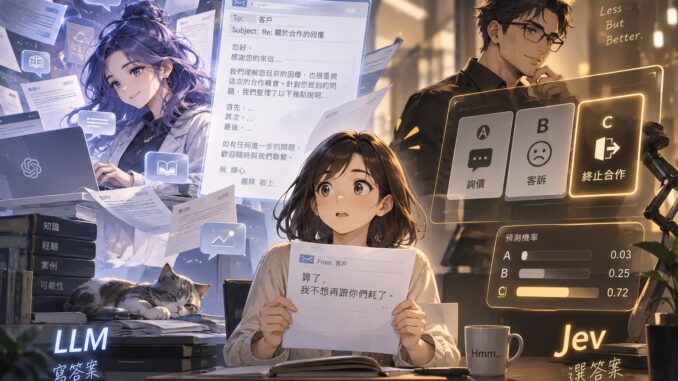
輸入:
  State: "客戶來信說『算了不想跟你們耗了』"
  Question: "這封信的意圖是什麼?"
  Options: ["詢價", "客訴", "終止合作"]

輸出:
  詢價 = 0.03
  客訴 = 0.25
  終止合作 = 0.72
根據官方文件,Jev 支援三種輸出類型(他們稱為 Primitive):
| 類型 | 功能 | 輸出範例 |
|---|---|---|
| Choice | 從預定義選項中選一個 | choice: "billing" |
| Score | 在連續量表上評分 | score: 1.4(如 0~2 分) |
| Noul | 是非判斷 | noul: 0.95(95% 機率為真) |
不管是哪一種,輸出都不是文字——而是分數或機率。
跟我們熟悉的 LLM 對話比一下:
| LLM(如 Claude、GPT) | Jev | |
|---|---|---|
| 輸入 | 自然語言 | 自然語言 + 預定義選項 |
| 輸出 | 完整文字段落 | 機率數字(如 0.72 / 0.25 / 0.03) |
| 回應時間 | 數秒到數十秒 | 70~500 毫秒 |
| 能不能聊天 | 可以 | 不行 |
| 能不能寫文章 | 可以 | 不行 |
看到這裡,我心裡的問題就更清楚了:輸出只有幾個數字,那它到底需要多聰明?
逆向推理背後邏輯
這是整篇文章的核心。我不打算從官方宣傳出發,而是反過來——從 Jev 的輸入和輸出,一步步推回去它的內部架構可能是什麼樣子。
第一步:輸出這麼簡單,代表什麼?
Jev 不生成任何文字。它不需要逐字逐句地「寫」出回答,只需要對預定義的選項打分數。
這在技術上意味著:它不需要自回歸解碼器。
一般 LLM 的工作方式是,每次預測下一個 token(可以想成一個字或一個詞),然後根據這個結果再預測下一個,一個接一個——這就叫自回歸(autoregressive)。你跟 ChatGPT 聊天時看到文字一個一個蹦出來,就是這個過程。
這個過程很慢,因為每個 token 都需要跑一次完整的模型計算。但 Jev 根本不需要這個——它只要一次計算,直接輸出所有選項的分數就好。
簡單來說:LLM 是一個字一個字地「寫」答案,Jev 是一次性地「選」答案。
第二步:但輸入是自然語言,又代表什麼?
雖然 Jev 不需要「寫」,但它必須「讀懂」。
客戶寫「算了不想跟你們耗了」,模型要能理解這句話背後的意圖。這種自然語言理解能力,目前幾乎只有 Transformer 架構能做到。所以 Jev 的底層,幾乎可以確定有某種 Transformer 在負責語義編碼。
但關鍵是——它只需要「讀」的能力,不需要「寫」的能力。
一個只需要讀懂語義的模型,和一個要能讀能寫能推理能創作的完整 LLM,需要的架構規模完全不同。
第三步:兩條線夾出來的,就是 Jev 的可能架構
- 輸出簡單 → 不需要生成能力 → 架構可以大幅精簡
- 輸入是自然語言 → 需要語義理解 → 必須有 Transformer 基礎
這兩條約束線夾出來的東西,大概長這樣:
自然語言輸入(State + Question + Options)
              ↓
      Transformer 語義編碼器
     (所有內容一起進去,互相參照)
              ↓
        各選項位置的語義表徵
              ↓
          Decision Head 評分
              ↓
      A = 0.72 / B = 0.25 / C = 0.03
跟完整 LLM 的對比:
LLM:
  自然語言 → Transformer → 世界表徵 → 自回歸解碼器 → 文字、文字、文字...

Jev(推測):
  自然語言 → Transformer → 語義表徵 → Decision Head → 0.72 / 0.25 / 0.03
注意,這裡的選項不只是被動地等著被配對。在我們推測的架構裡,選項在編碼階段就和 State 一起進入了 Transformer,透過注意力機制直接完成語義匹配。這種「把問題和答案一起編碼」的模式,在機器學習領域叫做 cross-encoder(交叉編碼器),BERT 做資訊檢索時就是這樣用的。
補充一點:前面提到 Jev 有三種輸出類型(Choice / Score / Noul),其中 Score 可以輸出連續數值(如 1.4 分),不只是從選項中選一個。這代表 Decision Head 不只做分類,還包含回歸能力——但本質上仍然是「讀懂語意後直接輸出數值」,不需要生成文字。
如果用一個技術性的名稱來描述這個推測架構,可以叫它 Semantic Decision Transformer(語意決策轉變器)——用 Transformer 做語義編碼,再透過專用的決策頭輸出機率或分數。白話一點就是:「會讀懂人話的通用判斷器」。
第四步:架構不一樣,學的東西也不一樣
順著這個架構推,我們可以再往前推一步——它的訓練方式一定也和 LLM 不同。
LLM 的訓練目標是「預測下一個 token」——它讀了一段文字,要猜接下來最可能出現什麼字。為了猜得好,它必須學會語法、常識、推理、寫作風格……什麼都得學。
但 Jev 不需要預測下一個字。它的訓練目標更可能是:「人類這樣描述一個情境時,它對應到哪個判斷?」
想像它的訓練資料長這樣:
情境:客戶寫「你們的服務太差了我要找律師」
問題:這封信的風險等級?
選項:[低, 中, 高]
正確答案:高(機率 0.95)
成千上萬筆這樣的「情境-問題-選項-答案」組合,可能由更強的 LLM 大量合成生成,讓 Jev 專門學會做判斷,而不是學寫文章。
這也解釋了一件事——Jev 不需要 LLM 那麼龐大的「世界知識」。想想看這兩者需要的能力差多少:
完整 LLM 需要的能力:
  理解 → 推理 → 回憶 → 寫作 → 解釋 → 創作 → 對話

Jev 需要的能力:
  語意理解 → 特徵辨識 → 判斷
LLM 要能寫出莎士比亞風格的十四行詩,所以它必須讀過莎士比亞。Jev 只需要判斷一封信是不是釣魚,它不需要知道莎士比亞是誰。能力越少,需要的知識越少,模型就越精簡,速度就越快。
從架構到訓練到規模,整條因果鏈都指向同一個方向。
第五步:效率數字怎麼來的?
有了這個架構假設,我們可以概算一下速度差異:
- 不做自回歸生成:假設 LLM 要生成 20 個 token 的 JSON,Jev 只需要一次前向傳遞 → 省約 20 倍
- 模型更小更專:不需要生成能力,參數量可以是完整 LLM 的幾分之一 → 再省約 10 倍
- 兩者相乘 → 大約 200 倍
嘿,這個數字恰好落在 TypeSafe 宣稱的範圍裡。不是巧合——從架構約束推出來的數字,和官方宣傳的數字能自洽,就是最強的間接驗證。
當然,實際數字取決於很多因素(比較基準、網路延遲、模型實際規模等),這只是量級估算。但至少方向是對的。
似曾相似的架構
如果你對機器學習有點底子,可能已經想到了——這不就是 BERT 嗎?
沒錯。Google 在 2018 年推出的 BERT,做的就是「Transformer 編碼器 + 分類頭」的事情。它能理解語言,但不生成文字,只做分類和判斷。而且它到現在還活得很好——bert-base-uncased 在 Hugging Face 上每月下載超過 4700 萬次(截至 2026 年 9 月)。
BERT 這條譜系也從來沒斷過:RoBERTa(2019)、DeBERTa(2020)、ModernBERT(2024)一路發展到現在。
那 Jev 和 BERT 有什麼不同?最關鍵的差異在一個地方:
| BERT | Jev | |
|---|---|---|
| 任務定義方式 | 訓練時寫死(每個任務微調一個模型) | 推論時用自然語言定義(單一模型) |
| 一個任務 | 需要一個專屬模型 | 同一組權重,換個問題就好 |
| 彈性 | 低(換任務要重新微調) | 高(換問題文字即可) |
這確實是 Jev 的真正創新——把 LLM 的「用提示詞定義任務」和 BERT 的「只做分類」結合起來。
但如果要我用一句話總結:Jev 不是什麼全新物種,而是 BERT 精神的現代繼承者,加上了 LLM 時代的動態任務定義能力。
以實際數據來驗證推測
以上都是我們自己推的。接下來,讓我們用這幾天冒出來的獨立評測數據,來驗證這些推測。
驗證一:正確性取決於問題設計
我們推測 Jev 本身不會推理,它只能從給定的選項裡做匹配。所以問題設計得好不好,直接決定準確率。
一個法國開發者在 Jev 發布兩天後做了釣魚信件偵測的基準測試(jev-phishing-bench),用 2000 封信(一半釣魚、一半正常)來測,結果非常有意思:
| 測試條件 | 準確率 |
|---|---|
| Jev — 單一問題「這是釣魚信嗎?」 | 62.6% |
| Jev — 拆成 5 個細項問題 + 邏輯回歸加權 | 95.0% |
| Claude Haiku 4.5 — 單一問題 | 81.3% |
| Claude Haiku 4.5 — 同樣 5 個問題 | 93.2% |
| 兩行正規表達式(regex)規則 | 91.8% |
同一個模型,問法不同,從 62.6% 跳到 95.0%——差了 32 個百分點。
而且更有趣的是:兩行 regex 就贏過 Jev 的單一問題。作者自己也承認那五個問題是他看過資料集的分類架構後才設計的,等於是針對資料集量身打造。
另一個用 18514 封信做的垃圾郵件測試(bitnovus/jev-spam-eval)也有類似的發現:給 Jev 精心設計的詳細判斷標準後,準確率達到 98.33%,跟 TF-IDF 邏輯回歸的 98.39% 幾乎相同。但作者特別說明,那些標準是經過反覆檢查錯誤案例、多次迭代後才制定出來的。
結論:我們推測「Jev 的天花板不是模型能力,而是選項設計者的預見能力」——完全被驗證。
驗證二:理解深度不足時,會高信心判錯
我們推測 Jev 在遇到超出理解深度的情況時,不是「不確定」,而是會自信地給出錯誤答案。
PriorBench 的獨立預註冊評測(2026-09-20)發現了一個經典案例:一個蛋糕食譜被 Jev 以 0.94 的信心分數歸類為「技術問題」,隨機字母串也拿到 0.97 的信心。
(0.94 信心說蛋糕食譜是技術問題!?…好吧或許烘焙確實是一門技術 XD)
但這不是笑話。在釣魚信件測試中,Jev 的期望校準誤差(ECE)是 0.154,Haiku 是 0.097——Jev 的信心分數明顯比 Haiku 更不可靠。
TypeSafe 自己的文件也承認了一個問題:同一個判斷,用 Noul 格式問回傳 0.22,用 Choice 格式問卻回傳 0.99 信心的「否」。連內部一致性都有落差。
值得注意的是,TypeSafe 的官方文件裡其實自己也寫了這句話:
「Calibration is measured across groups of predictions; it does not guarantee that an individual answer is correct.」
(校準是在群體預測層面衡量的,不保證個別回答正確。)
也就是說,即使整體校準做得好,個別判斷仍然可能錯——而且信心分數不能告訴你「這一次」是不是錯的那個。
結論:我們推測「可能以高信心判錯」——不只被獨立評測驗證,連官方自己都承認了。
驗證三:效率數字的真相
我們粗算出來的 200 倍加速是一個理論上限。實際上呢?
| 測試來源 | 比較對象 | 速度差 | 成本差 |
|---|---|---|---|
| TypeSafe 官方 | 前沿 LLM(最貴的) | 193.6x | 444.6x |
| Every 獨立實測 | Claude Fable 5.1 | 25x | 580x |
| 釣魚信件測試 | Claude Haiku 4.5 | 2.9x | 12x |
同一個產品,比較基準不同,數字可以差 60 倍以上。
官方的 193.6 倍是拿最貴最慢的前沿模型來比。跟同樣定位為「快且便宜」的 Haiku 比,速度差就只剩 2.9 倍了。Jev 確實快,但沒有標題數字暗示的那麼誇張。
驗證四:「零幻覺」的語義閃躲
TypeSafe 宣稱 Jev 零幻覺。聽起來超厲害,對吧?
但 The Rundown 的評論一句話就點破了:「一個模型可以從允許的選項中做出選擇,同時仍然做出錯誤的判斷。」
TypeSafe 自己的部落格也寫了:0% 幻覺這個數字是因為 schema conformance by design(設計上保證格式正確),不是實際測量的結果。
簡單來說就像——選擇題全部填 A 也不會「幻覺」,但不代表答對了。格式正確和判斷正確是兩回事。
所以 Jev 適合什麼?不適合什麼?
經過這一輪從推測到驗證,可以畫出一個相當清楚的邊界:
適合的場景:
- 問題空間已被充分理解,所有合理答案可以預先窮舉
- 需要大量、高頻、低延遲的語義判斷(路由、分類、風險分級)
- 分類標準會變動,需要用自然語言動態定義任務
- 成本敏感的高量場景
不適合的場景:
- 需要多步推理的複雜判斷
- 需要生成文字、解釋原因
- 可能遇到預定義選項沒覆蓋到的例外情況
- 需要理解潛台詞、反諷等深層語義
用一個比喻來說:Jev 是脊髓反射,不是大腦皮層。 大部分訊號在脊髓層級就處理完了,只有少數才需要上傳到大腦。它的價值不在思考的品質,而在反應的速度。
寫在最後
這篇文章裡,我們沒有跑任何一行程式碼,也沒有呼叫任何一次 API。我們只是問了一個很樸素的問題:「輸出這麼簡單,它到底需要什麼能力?」然後從這個問題出發,一步步反推出了 Jev 的可能架構、效率來源、和能力邊界。
然後再用獨立評測的數據去驗證——結果每一條推測都對上了。
這不是因為我們猜得準,而是因為從結構性約束出發的推理,比從宣傳數字出發的理解更穩固。宣傳數字可以被比較基準影響、被行銷包裝放大,但一個模型的輸入輸出形式決定了它能力的邊界——這是不會變的。
下次看到「快 200 倍」「零幻覺」這種標題,記得先問一句:它的輸出是什麼? 從那裡開始想,比看十篇評測文都有用。
(謎之音:逆向推理花腦力,但可以省下很多被炒作帶風向的冤枉路….XD)
參考資料
官方資料:
- TypeSafe AI Blog — Introducing System One Models & Jev(2026-09-15):
https://typesafe.ai/blog/introducing-system-one-models-and-jev - TypeSafe AI — System One Concept(官方架構說明):
https://docs.typesafe.ai/concepts/system-one.md - TypeSafe AI — Jev 1.13 Jaggedness(模型已知限制):
https://docs.typesafe.ai/model-jaggedness/jev-1.13 - TypeSafe AI — 官方文件:
https://docs.typesafe.ai/models
獨立基準測試:
- jev-phishing-bench — 釣魚信件偵測基準測試(2026-09-17):
https://github.com/anisselbd/jev-phishing-bench - PriorBench — Jev 獨立預註冊評測(2026-09-20):
https://github.com/priorbench/jev - jev-benchmark — Agent 工具呼叫風險分類測試(2026-09-17):
https://github.com/themsquared/jev-benchmark - bitnovus/jev-spam-eval — 垃圾郵件偵測基準測試:
https://github.com/bitnovus/jev-spam-eval
深度分析文章:
- Sean Goedecke — “Jev means structured output is interesting again”(2026-09-16):
https://www.seangoedecke.com/jev-means-structured-output-is-interesting-again/ - XenoSpectrum — “Jev, the AI That Never Writes a Sentence”(2026-09-20):
https://xenospectrum.com/en/jev-typesafe-bert-classifier-decomposition/ - Anthony Maio — “Jev: The Language Model That Won’t Talk”:
https://anthonymaio.substack.com/p/jev-the-language-model-that-wont
評論與評測:
- Kingy AI — TypeSafe Jev Review:
https://kingy.ai/blog/typesafe-jev-review-the-ai-model-that-doesnt-generate-text/ - ActionBox — TypeSafe AI Jev Review: Tested vs LLMs, API & Benchmarks:
https://actionbox.cloud/blog/typesafe-ai-jev-review/ - DataCamp — Jev: TypeSafe’s System One Model:
https://www.datacamp.com/blog/system-one-models-jev - DEV Community — “I Benchmarked Jev on Agent Tool-Call Risk”(2026-09-19):
https://dev.to/webofmike/i-benchmarked-jev-on-agent-tool-call-risk-calibration-held-49i3 - The Rundown AI — TypeSafe launches Jev for AI decisions inside software:
https://www.therundown.ai/news/typesafe-jev-ai-decisions-software - Forkast — TypeSafe AI’s Jev Is Not an LLM — And That May Be the Point:
https://forkast.news/typesafe-ais-jev-is-not-an-llm-and-that-may-be-the-point/ - THE DAILY BRIEF — TypeSafe’s Jev Scores 62.6% Asked Once and 95% Split Five Ways:
https://www.beri.net/article/typesafe-jev-typed-decision-model-calibration-decomposition-shadow-eval
學術基礎:
- Google Research — Confident Adaptive Language Modeling / CALM(NeurIPS 2022):
https://arxiv.org/abs/2207.07061 - “Early Exit Is a Natural Capability in Transformer-based Models”(2024):
https://arxiv.org/abs/2412.01455 - BERT 原始論文 — “Pre-training of Deep Bidirectional Transformers for Language Understanding”(2018):
https://arxiv.org/abs/1810.04805